Ali naj se umetna inteligenca uči na vaši vsebini? Google uvaja skupni signal v robots.txt
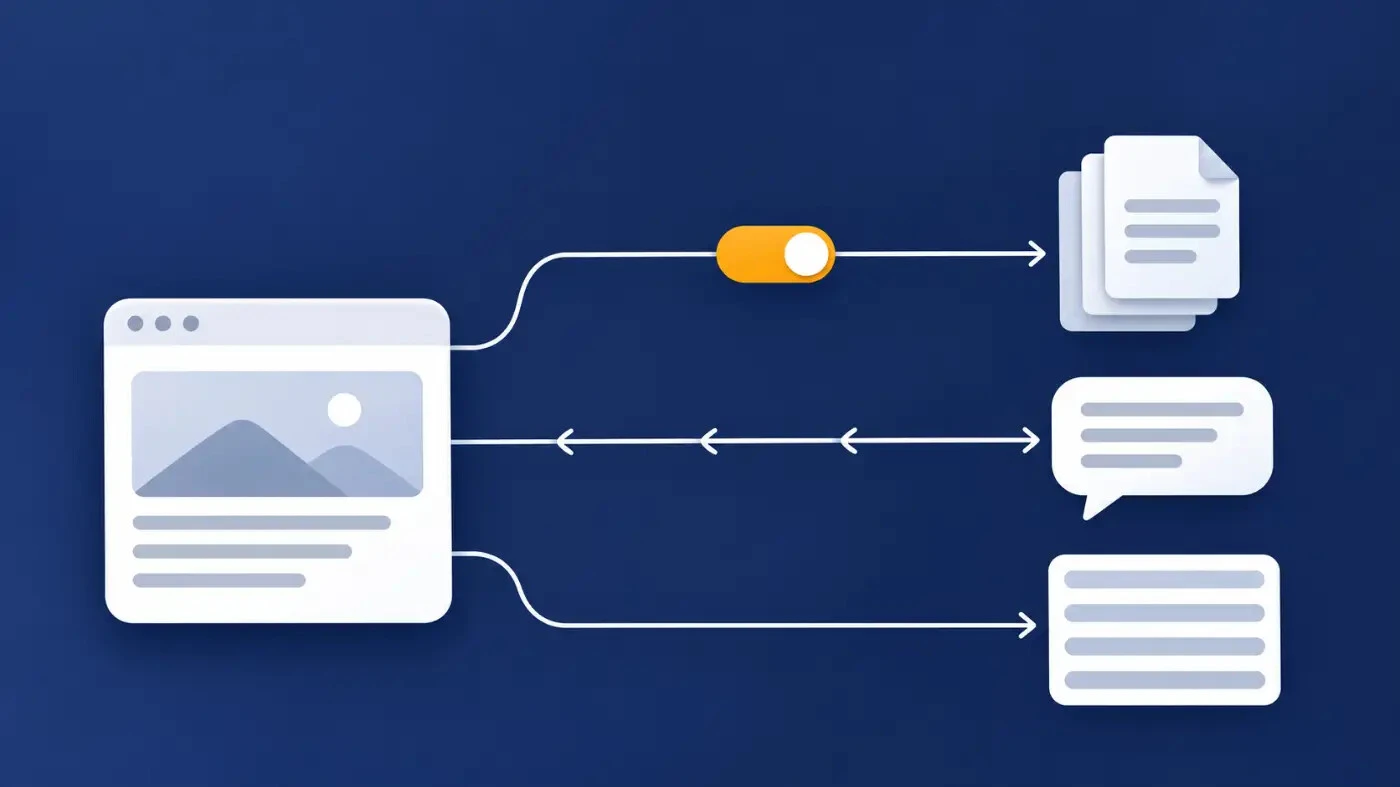
Google je 30. oktobra 2026 napovedal novost, ki se na prvi pogled zdi tehnična malenkost, od vodstva podjetij pa v resnici zahteva poslovno odločitev. V datoteki robots.txt bo lastnik spletne strani z enim samim zapisom povedal vsem sodelujočim ponudnikom umetne inteligence, ali smejo njegovo vsebino uporabiti za učenje svojih velikih jezikovnih modelov (LLM, Large Language Model). Google bo signal pričel upoštevati v začetku leta 2027.
Odločitev se zdi preprosta: prepovemo ali dovolimo? Kdor pa bo robote umetne inteligence zaprl na slepo, lahko s tem izgubi zelo obetajoč kanal, ki ga večina podjetij sploh še ne meri. Na portalu si21.com, ki ga razvijamo in gostimo sami, so AI iskalniki oz. veliki jezikovni modeli umetne inteligence pripeljali več obiskovalcev kot vse druge napotitvene spletne strani skupaj.
Kaj točno je napovedal Google?
Do zdaj je moral upravljalec spletne strani pisati ločena navodila za vsak AI posebej: eno za Google (Gemini), drugo za OpenAI (ChatGPT), tretje za Anthropic (Claude). Seznam se je daljšal iz meseca v mesec. Delovna skupina AIPREF pri organizaciji IETF, ki skrbi za internetne standarde, je zato pripravila skupen zapis. V robots.txt ga bo mogoče dodati kot posebno skupino z oznako __usage_ai-training.
Ko bo stran s tem zapisom prepovedala učenje in Googlove oznake Google-Extended ne bo omenila posebej, bo Google to razumel enako, kot da je prepovedala Google-Extended. Drugi ponudniki naj bi signal obravnavali podobno. Obstoječa navodila za posamezna podjetja ostanejo veljavna, zato lahko splošno odločitev dopolnite z izjemami.
Google še navaja, da je predlog usklajen z evropskim kodeksom ravnanja za ponudnike splošnih modelov po Aktu o umetni inteligenci. Ta kodeks robots.txt priznava kot glavni način, s katerim lastniki spletnih vsebin izrazijo svojo voljo, ali naj bo vsebina na njihovi spletni strani na voljo za učenje AI-jev.
Učenje, navajanje in iskanje niso ista stvar!
Tu se najpogosteje motimo. Umetna inteligenca vašo stran obišče iz treh različnih razlogov, ki imajo za vaše poslovanje različne posledice.
- Učenje modela. Pajek zbira besedila, iz katerih se bo učila prihodnja različica modela. Vaša stran od tega nima neposredne koristi.
- Navajanje v odgovoru. Ko uporabnik vpraša ChatGPT ali Gemini, kje kupiti stanovanje v Ljubljani, orodje v trenutku poišče vire, jih navede in nanje poveže. To je promet, ki prinaša obiskovalce.
- Klasično iskanje. Googlebot stran indeksira za Googlov iskalnik, vključno s povzetki umetne inteligence na vrhu rezultatov.
Novi signal se nanaša na prvo točko. Vendar je pomembno razumeti izjemo. Google-Extended ne nadzira samo učenja modelov Gemini, ampak tudi uporabo vaše vsebine v odgovorih aplikacije Gemini. Google piše, da so do prikaza in klikov iz teh odgovorov upravičene strani, ki Google-Extended dovolijo. Kdor učenje prepove s skupnim signalom, se torej odreče tudi temu. Na uvrstitev v klasičnem Google iskanju to ne vpliva, saj Google-Extended po Googlovih navedbah ni dejavnik razvrščanja.
Kaj kažejo podatki portala si21.com
Teorijo smo preverili na podatkih portala si21.com, ki deluje na Kabi platformi. V spletni analitiki smo pregledali vire obiska:
Tabela virov obiska na portalu Si21 - oktober 2026
|
Vir obiska |
Obiski |
Dejanja na obisk |
Stopnja odboja |
|---|---|---|---|
|
Iskalniki |
38.503 |
11,8 |
26 % |
|
Neposreden obisk |
29.897 |
29,5 |
78 % |
|
Družbena omrežja |
6.730 |
5,2 |
33 % |
|
Pomočniki umetne inteligence |
1.131 |
5,8 |
41 % |
|
Druge spletne strani |
764 |
8,6 |
44 % |
Veliki AI jezikovni modeli so prinesli približno 1,5 % vsega obiska. Delež je majhen, a že presega obisk z vseh drugih spletnih strani, ki se povezujejo na to spletno stran. Od 1.131 obiskov jih je 1.107 prišlo iz ChatGPT, 17 iz Gemini, preostalih nekaj pa iz Perplexity, Copilot, Duck.ai in Claude.
Podatki imajo tudi drugo plat, ki je ne bomo olepševali. Obiskovalci iz iskalnikov si v povprečju ogledajo dvakrat več strani in redkeje takoj odidejo. Obisk iz odgovorov umetne inteligence je trenutno še prezgodaj ocenjevati, kako kakovosten dejansko je. Prav zato ga je nespametno izklopiti, preden ga sploh izmerimo. Kdor bi danes na slepo zaprl vse robote umetne inteligence, bi tem obiskovalcem zaprl vrata, ne da bi vedel, koliko povpraševanj so prinesli.
Kako se obnaša obisk iz klasičnih iskalnikov v primerjavi z obiskom iz umetne inteligence, smo podrobneje opisali v primerjavi obiska iz klasičnih in AI iskalnikov.
Kako pri Kabiju ravnamo z roboti umetne inteligence?
Na strežnikih, kjer izvajamo gostovanje spletnih strani naših strank, robote umetne inteligence spustimo do vsebine le, če prihajajo z IP naslovov, ki jih ponudniki uradno objavljajo za svoje pajke. Zahtevek, ki se predstavi kot GPTBot ali Googlebot, a prihaja z drugega IP naslova, blokiramo. Ime robota lahko ponaredi vsak, uradnega IP naslova pa ne. Tako ločimo prave pajke od robotov, ki se zanje le izdajajo in spletni strežnik obremenjujejo brez kakršne koli koristi. Kako hitro tak promet narašča, smo pokazali v članku o tem, kako AI roboti vplivajo na delovanje spletnih strani in trgovin.
Datoteko robots.txt za stranke urejamo mi, na njihovo zahtevo. Ko bo Google signal začel upoštevati, bomo zapis dodali vsem strankam, ki to želijo. Pred tem se z vsako pogovorimo, kaj pravzaprav želi zaščititi. Robots.txt pa ni edina datoteka, katere pravila upošteva umetna inteligenca. O drugi smo pisali v članku kaj je llms.txt.
Tri vprašanja za vodstvo pred odločitvijo
- Ali je vaša vsebina vaš izdelek? Založniki, izobraževalne ustanove in svetovalci, ki prodajajo znanje, imajo dober razlog, da učenje prepovejo.
- Ali vaša vsebina prodaja nekaj drugega? Opisi nepremičnin, izdelkov in storitev obstajajo zato, da jih najde čim več ljudi. Tu prepoved učenja pogosto deluje proti vam, posebej pri Googlu, kjer z njo izgubite tudi navajanje v odgovorih Gemini.
- Ali promet iz umetne inteligence sploh merite? Če ne, najprej uredite merjenje, šele nato se odločite. Hiter preizkus opisuje članek kako v 3 korakih preveriti, ali se vaša stran pojavlja v AI rezultatih.
Za večino podjetij, ki jim izdelujemo spletne strani, je smiselna srednja pot: dovolite navajanje in iskanje, učenje pa omejite le tam, kjer je vsebina sama vir prihodka. Robots.txt to omogoča, ker lahko skupnemu signalu dodate izjeme za posamezne ponudnike.
Kaj lahko storite že zdaj?
Signal bo začel veljati šele leta 2027, kar je dovolj časa za premišljeno odločitev. Predlagamo štiri korake:
- V analitiki ločite obisk iz velikih jezikovnih modelov umetne inteligence od drugih napotitev.
- Preverite, katere robote vaš robots.txt danes dovoli in katere blokira. Pogosto se izkaže, da je nekdo pred leti dodal prepovedi, ki jih danes nihče več ne razume ali niso več potrebne.
- Z vodstvom se dogovorite, katera vsebina je izdelek in katera prodajni pripomoček.
- Poskrbite, da je vsebina, ki naj jo umetna inteligenca navaja, jasno urejena. Pri tem pomagajo strukturirani podatki in premišljena GEO optimizacija.
Če vašo stran gostimo in vzdržujemo mi, nam svojo odločitev le sporočite, nastavitev pa uredimo v okviru vzdrževanja spletne strani. Če je ne, vam pregledamo trenutni robots.txt in analitiko ter predlagamo nastavitev, ki ustreza vašemu poslovanju. Več o našem pristopu najdete na strani optimizacija spletnih strani, sorodne članke pa v rubriki Marketing in SEO optimizacija.
Priporočamo
Poglej več
Več kot 500 spletnih strani zaščitenih pred kritičnima ranljivostma PHP
Študija primera SEO: več klikov iz Googla in boljša uvrstitev